
O caso BP-Husky explica alarm flooding, situações anormais, barreiras e investigação sistêmica. Vídeo oficial do CSB e checklist de gerenciamento de alarmes.
Alarming Mistakes, Deadly Decisions: Fatal Fire at BP-Husky
Vídeo oficial do CSB, em inglês. Use as opções de legendas e tradução do player, quando disponíveis.
O número que revela a sobrecarga
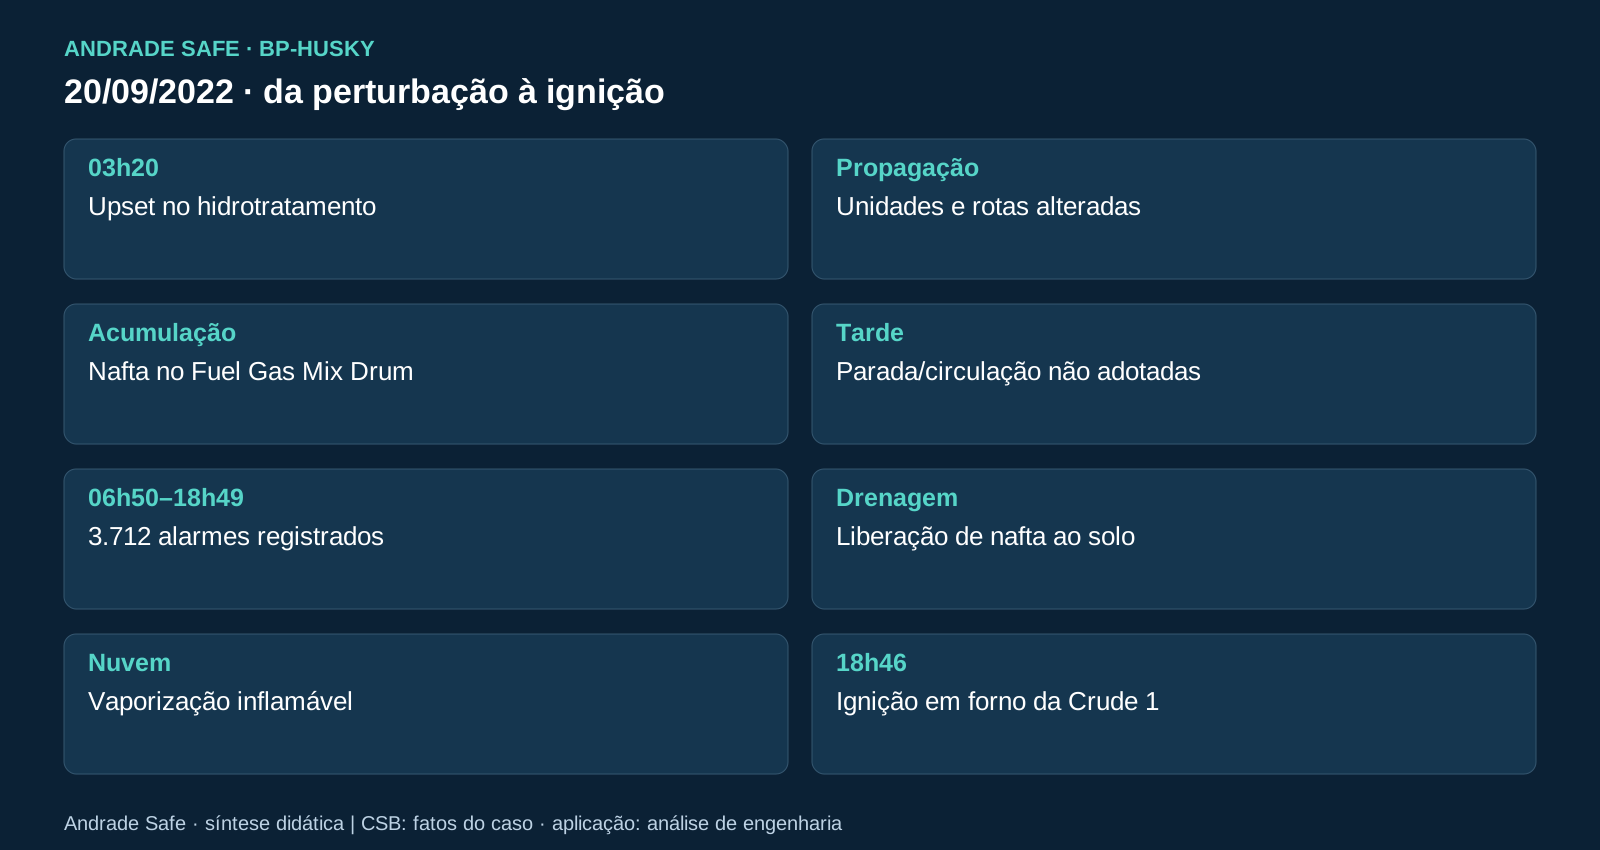
3.712 alarmes em quase 12 horas. Na refinaria BP-Husky Toledo, em Oregon, Ohio, esse foi o volume registrado entre 6h50 e 18h49 de 20 de setembro de 2022. A média simples fica em aproximadamente 310 alarmes por hora, ou pouco mais de cinco por minuto. Ela não informa os picos, a simultaneidade nem a distribuição entre posições de operação: serve apenas para dar escala à sobrecarga.
Há um detalhe importante: a ignição ocorreu às 18h46. Portanto, a janela de contagem do CSB termina três minutos depois da ignição; os 3.712 não devem ser apresentados como uma contagem encerrada exatamente antes do incêndio. O título resume um período de quase 12 horas de inundação de alarmes.
Um alarme só protege quando alguém consegue perceber, entender e agir dentro do tempo disponível. Quando centenas de sinais competem pela mesma atenção, a informação que deveria orientar pode virar ruído. O problema deixa de ser apenas eletrônico: envolve processo, interface, carga cognitiva, comunicação e decisões organizacionais.
O novo vídeo do U.S. Chemical Safety and Hazard Investigation Board (CSB), anunciado em 30 de setembro de 2026 e catalogado em 1º de outubro, retoma a investigação final de 2024. Este artigo usa essa investigação para examinar barreiras e condições de trabalho, sem reduzir duas mortes a uma acusação de erro individual.

O que aconteceu na BP-Husky
Por volta de 3h20, uma perturbação operacional, ou upset, na unidade de hidrotratamento de nafta desencadeou uma perda de contenção. Essa unidade trata uma fração leve do petróleo; sua indisponibilidade afetou outras partes da refinaria e alterou os caminhos pelos quais as correntes de processo circulavam.
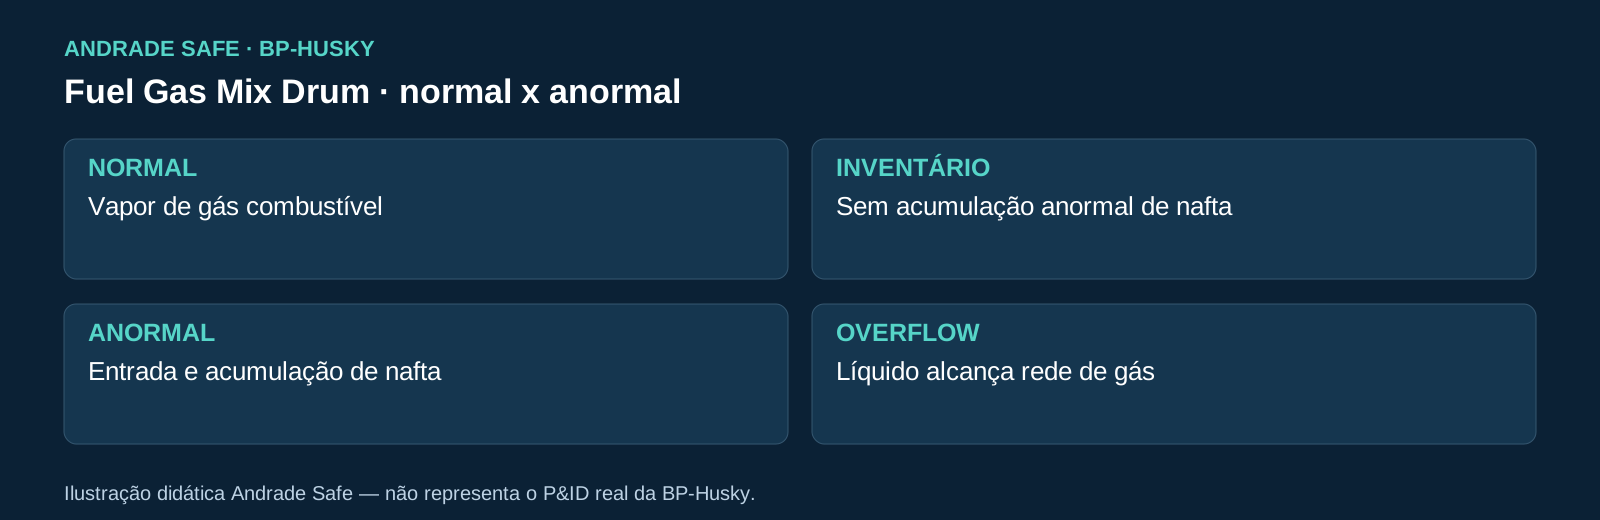
A Crude Unit 1 realiza a separação inicial do petróleo por destilação. A Coker Gas Plant processa correntes gasosas associadas ao coqueamento. Na configuração anormal daquele dia, o bypass da Coker Gas Plant tornou-se parte do caminho pelo qual nafta líquida chegou ao Fuel Gas Mix Drum, um vaso pressurizado da rede de gás combustível. Normalmente esse vaso continha vapor, não um inventário crescente de nafta.
O líquido acumulado passou a ameaçar a tubulação destinada a levar gás combustível a fornos e caldeiras. Alimentar esses equipamentos com líquido no lugar de gás cria outro cenário perigoso. Na tarde daquele dia, liderança e engenharia discutiram parar a Crude 1 ou colocá-la em circulação para estabilização. A decisão naquele momento foi não implementar nenhuma das alternativas.
O CSB registrou que um e-mail resumindo a reunião não foi enviado e não encontrou evidência de transmissão adequada das decisões ao turno seguinte. Em meio à deterioração operacional, trabalhadores foram orientados a drenar o vaso rapidamente. A investigação concluiu que eles podem ter acreditado que o conteúdo era uma solução de amina e água, e não nafta inflamável. Isso é uma conclusão probabilística do CSB, não uma certeza sobre o pensamento de cada pessoa.
A liberação ao solo gerou vaporização e uma nuvem inflamável. Às 18h46, ela alcançou um forno da Crude Unit 1 e entrou em ignição, produzindo um flash fire. Duas pessoas morreram. O CSB informou mais de 23.000 lb de nafta liberadas — mais de 10,4 toneladas, por conversão de unidades — e aproximadamente US$ 597 milhões em danos, incluindo perda de uso.
| Questão de segurança identificada pelo CSB | O que estava em jogo |
|---|---|
| Prevenção de overflow | Evitar que líquido ultrapassasse o vaso e alcançasse a rede de gás. |
| Gestão de situações anormais | Reconhecer a perda de estabilidade e decidir como chegar ao estado seguro. |
| Alarm flood | Preservar a capacidade de reconhecer e responder a alarmes críticos. |
| Aprendizado com incidentes | Transformar sinais anteriores em barreiras eficazes. |
Fuel Gas Mix Drum: quando um vaso de vapor recebe líquido
Um sistema de fuel gas distribui combustível gasoso a consumidores como fornos e caldeiras. Um vaso nessa rede pode cumprir funções de mistura e separação conforme o projeto. O desenho real inclui conexões, instrumentos, proteções e condições que uma ilustração editorial não reproduz.
No caso investigado, a questão não era apenas pressão: era a entrada e acumulação de uma fase líquida num sistema concebido para transportar vapor. Uma válvula de alívio de pressão, por exemplo, não deve ser presumida como solução de proteção contra qualquer transbordamento. O cenário de nível alto e arraste precisa de análise própria.
A lição de engenharia é avaliar caminhos plausíveis de líquido durante operação normal, partida, parada, bypass e perturbações. A barreira precisa interromper o mecanismo perigoso antes que o operador seja colocado diante de uma escolha urgente e mal informada.
O que é alarm flooding?
Alarm flooding, ou inundação de alarmes, é uma condição em que a quantidade e a taxa de chegada de alarmes ultrapassam a capacidade prática de discriminação e resposta da equipe. Reconhecer ou silenciar uma indicação na tela não equivale a diagnosticar sua causa ou recuperar o processo.
Alarmes consequenciais aparecem depois de uma perturbação inicial. Alarmes duplicados repetem o mesmo problema por instrumentos diferentes. Nuisance alarms são indicações recorrentes ou pouco úteis; stale alarms permanecem ativos por longos períodos. Essas situações podem aumentar a procura por informação justamente quando o tempo para decidir está diminuindo.
Os termos ajudam a analisar o sistema, mas não substituem o histórico real de alarmes. Para saber quais sinais ocultaram os mais importantes, é preciso confrontar timestamps, tendências de processo, ações, posição de operação e configuração vigente. Ter menos indicações só representa melhora quando as informações necessárias continuam disponíveis.
Alarme, evento, trip e SIS não são a mesma coisa
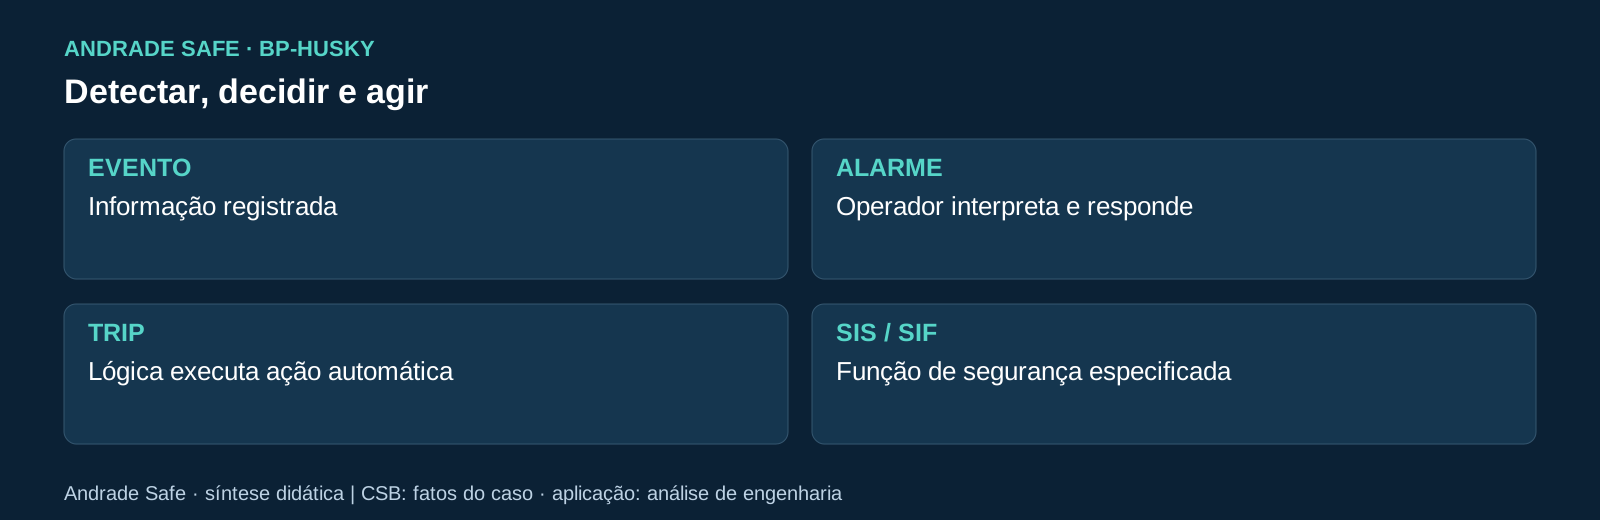
Um evento pode ser apenas um registro de mudança de estado. Um alarme sinaliza uma condição que requer resposta do operador. Um trip ou intertravamento executa uma ação automática segundo sua lógica. Um Safety Instrumented System (SIS) implementa funções instrumentadas de segurança (SIFs), cuja especificação e independência devem decorrer da análise de risco.
Uma tela pode mostrar tanto alarmes do controle básico quanto indicações provenientes de um SIS. Isso não torna o aviso na tela uma função independente de proteção. A pergunta é qual mecanismo detecta, decide e age, e quais falhas podem afetar mais de uma barreira.
| Recurso | Quem decide e age? | O que verificar |
|---|---|---|
| Evento | Pode apenas registrar informação. | É necessário chamar atenção ou basta guardar o histórico? |
| Alarme | O operador interpreta e responde. | Há ação definida e tempo suficiente? |
| Trip / intertravamento | A lógica comanda uma ação automática. | O cenário, o teste e o modo de falha foram avaliados? |
| SIS / SIF | Instrumentação e lógica de segurança atuam conforme especificação. | Independência, integridade, testes e gestão do ciclo de vida. |
3.712 alarmes não significam 3.712 riscos independentes
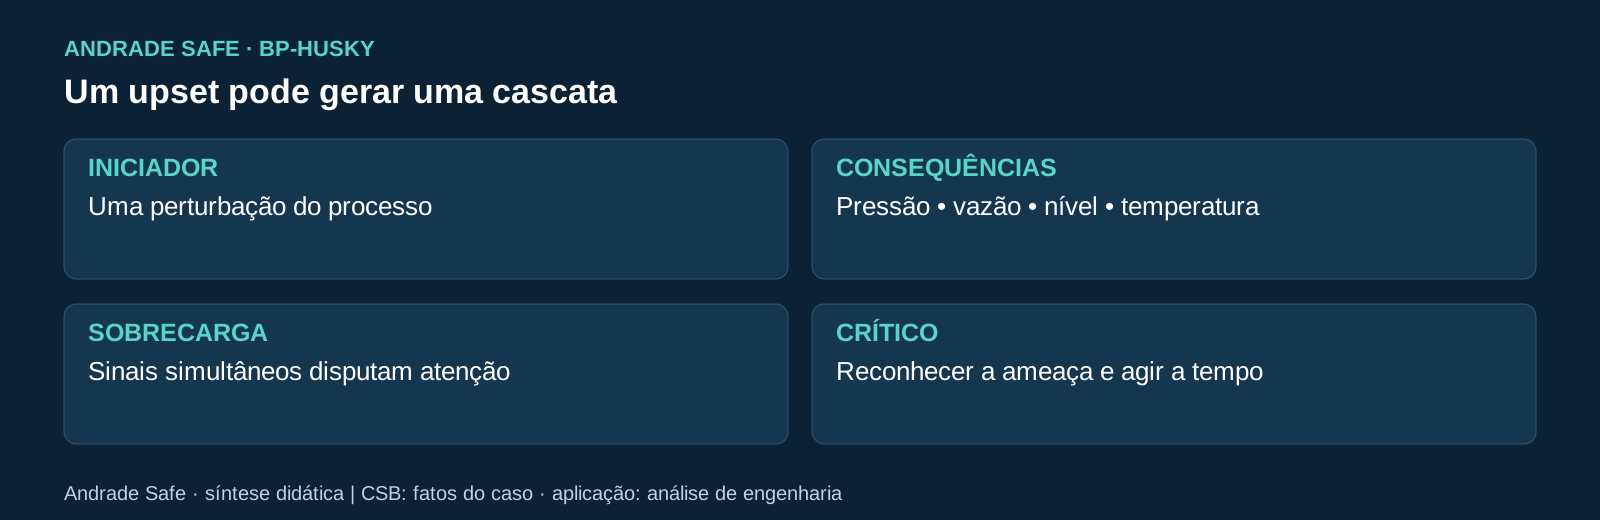
Uma única perda de estabilidade pode afetar pressão, temperatura, vazão e nível em muitos equipamentos. A cascata resultante pode gerar dezenas de sinais sobre consequências do mesmo problema. Contar todos como riscos independentes distorce a compreensão; descartá-los como repetição também pode ocultar uma escalada real.
O diagnóstico precisa distinguir o sinal iniciador, as consequências esperadas e as condições que indicam uma nova ameaça. Uma média mensal pode parecer confortável e esconder um episódio extremo. Avalie cada inundação: duração, volume, pico, alarmes de maior relevância e capacidade real de executar as respostas.
Não existe neste artigo uma taxa universal de alarmes aceitáveis. A adequação depende do processo, da posição de operação, do contexto e das referências técnicas aplicáveis. O objetivo é recuperar significado, não alcançar um número bonito no painel.
Quando tudo é prioridade, nada é prioridade
Racionalizar um alarme é justificar sua existência. A equipe deve registrar a condição detectada, a causa plausível, a consequência se nada for feito, a ação esperada e o tempo de resposta. A prioridade decorre dessas condições; não deveria nascer de uma configuração padrão de fornecedor.
Uma pergunta prática é: o que exatamente o operador fará ao receber esta indicação? Se a resposta for apenas reconhecer a mensagem, talvez ela seja um evento. Se duas indicações pedem a mesma ação sobre a mesma condição, avalie a redundância. Se a ação não cabe no tempo disponível, adicionar um alarme não resolve a insuficiência da proteção.
Shelving é a suspensão temporária e governada de um alarme, com motivo e prazo. Supressão por estado pode impedir indicações sem sentido durante determinadas condições de operação. Ambas precisam de regras, registro e revisão; ocultar uma condição perigosa sem controle reduz a visibilidade do risco.
Na consulta de 7 de outubro de 2026, o catálogo público da ISA lista ANSI/ISA-18.2-2016; a IEC lista IEC 62682:2022, edição 2.0; e a EEMUA apresenta a publicação 191 em quarta edição. São referências internacionais para o gerenciamento de alarmes, não tabelas reproduzidas aqui nem substitutos da análise de engenharia.
Situações anormais exigem outra forma de operar
Abnormal situation management é a gestão das condições em que o controle básico já não consegue manter o processo estável. Quando unidades param, rotas mudam e vasos acumulam material inesperado, o procedimento normal pode deixar de representar o trabalho real.
A organização precisa definir gatilhos de escalonamento, responsáveis, recursos e critérios para shutdown, circulação ou outro estado seguro. Parar não é necessariamente apertar um botão: uma parada mal conduzida também pode criar riscos. A condição segura e a sequência para alcançá-la devem ser estudadas antes da emergência.
Considere, como aplicação didática, um nível que continua subindo apesar das ações previstas e cuja origem ainda é incerta. Isso exige reavaliar a manutenção da alimentação e a capacidade de contenção, usando os procedimentos autorizados. Improvisar uma drenagem para resolver o indicador pode transferir o perigo do equipamento para pessoas e ambiente.
Handover: uma decisão precisa chegar ao próximo turno
Passagem de turno é um controle de risco. Um resumo não enviado e decisões sem confirmação de recebimento deixam a equipe seguinte com uma representação incompleta do processo. O CSB documentou esse problema na BP-Husky; a aplicação preventiva é criar comunicação que sobreviva à sobrecarga.
Em situação anormal, o handover deve explicitar configuração atual, unidades paradas, bypasses, equipamentos indisponíveis, alarmes suprimidos, níveis e tendências preocupantes, decisões pendentes e critérios de escalonamento. A equipe que recebe precisa confirmar o entendimento e saber quem responde pelo próximo passo.
Registrar é necessário, mas não basta. Uma alteração crítica deve ser transmitida e validada com a equipe relevante, sem depender apenas de alguém encontrar um e-mail enquanto responde a dezenas de alarmes.
Stop Work Authority precisa funcionar sob pressão
Stop work authority é a autoridade para interromper uma tarefa percebida como insegura até que a situação seja resolvida. Ela deve indicar como acionar a liderança, proteger a equipe exposta, avaliar o risco e autorizar a retomada. Uma política que só aparece no treinamento inicial oferece pouco apoio durante uma emergência.
O CSB recomendou procedimentos e treinamento regular, com ênfase em situações anormais e alarm floods. Para funcionar, essa autoridade precisa de legitimidade: quem pede a pausa deve obter escuta e suporte, inclusive quando há pressão para preservar produção ou recuperar uma unidade.
Interromper uma tarefa de campo e levar uma unidade ao estado seguro são decisões relacionadas, mas distintas. A primeira protege diante de uma ameaça percebida; a segunda precisa da sequência operacional apropriada. A organização deve permitir que a dúvida seja escalada antes de uma ação irreversível.
Alarmes não devem ser a única barreira contra um evento grave
Uma resposta humana depende da detecção, da interface, do entendimento, da disponibilidade de pessoas e do tempo. Quanto mais severa a consequência possível, mais importante examinar se a proteção ficou dependente de uma única sequência de percepção e reação.
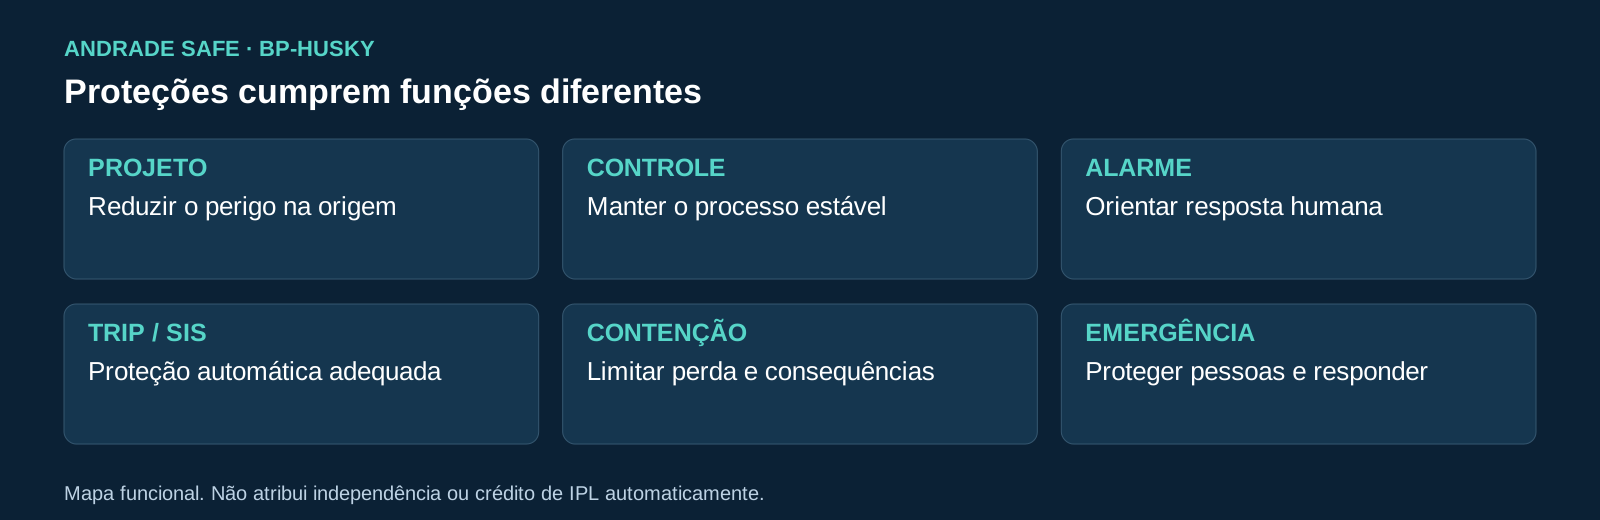
Projeto intrinsecamente mais seguro, prevenção de overflow, instrumentação de nível, controle básico, intertravamentos, SIS, alívio, contenção, drenagem segura e emergência cumprem funções diferentes. A necessidade e a configuração de cada recurso dependem do processo e da análise de risco; não existe uma receita única de instalar todos.
Também não se deve contar automaticamente cada caixa do desenho como uma camada independente de proteção (IPL). Independência, especificidade, confiabilidade, auditabilidade e causas comuns de falha precisam ser demonstradas. Duas indicações usando o mesmo sensor, por exemplo, podem compartilhar a mesma vulnerabilidade.
O evento de 2019: aprender exige mudar as barreiras
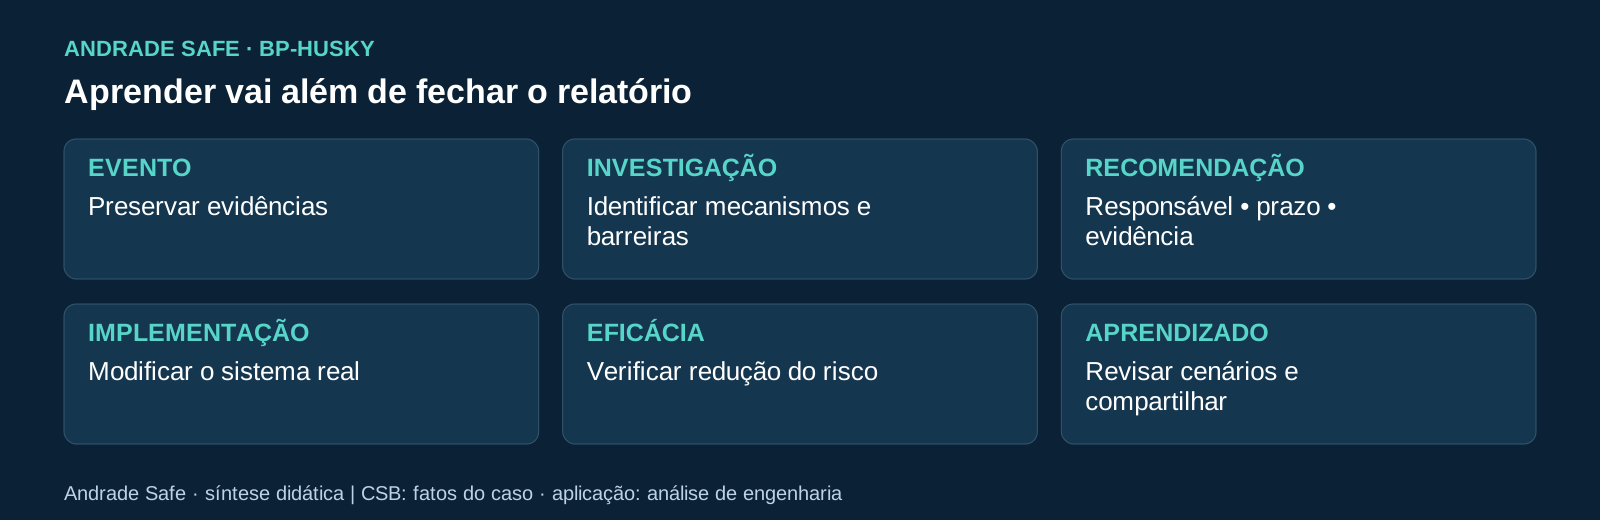
Em 2019, uma perturbação na refinaria já havia permitido a entrada de nafta no Fuel Gas Mix Drum. Segundo o CSB, a investigação interna reconheceu sinais de potencial catástrofe, mas não produziu ações suficientes para impedir que o mecanismo se repetisse.
A pergunta útil não é apenas se houve relatório. É se as recomendações atingiram o caminho físico da falha, se tiveram responsável e prazo, se foram implementadas e se a eficácia foi verificada. Uma ação administrativa encerrada no sistema pode coexistir com o mesmo cenário perigoso no campo.
Near misses devem alimentar revisão de cenários, procedimentos e salvaguardas. Simulações, testes e inspeções podem verificar se a intervenção mudou a resposta do sistema. A investigação termina quando existe evidência de redução do risco, não quando o arquivo recebe a etiqueta de concluído.
O que mudou: status das sete recomendações
O quadro abaixo registra a consulta ao CSB em 7 de outubro de 2026. São sete recomendações: quatro à Ohio Refining Company, duas à API e uma à ISA. Três estavam fechadas e quatro abertas. O relatório final foi publicado em 24 de junho de 2024; recomendação aberta não significa que a investigação esteja sem conclusão.
Resposta aceitável indica uma proposta considerada adequada, ainda pendente de conclusão. Ação aceitável indica atendimento encerrado pelo Board. Ação alternativa aceitável é um fechamento por uma solução alternativa. Esses estados não certificam a segurança de toda a instalação.
Consultar o status oficial das sete recomendações →
| ID 2022-01-I-OH | Destinatário / tema | Status no CSB |
|---|---|---|
| 1 | Ohio Refining Company — salvaguardas contra overflow | Open — Acceptable Response or Alternate Response |
| 2 | Ohio Refining Company — situações anormais | Closed — Acceptable Alternative Action |
| 3 | Ohio Refining Company — stop work authority | Closed — Acceptable Action |
| 4 | Ohio Refining Company — Toledo Alarm Philosophy | Closed — Acceptable Action |
| 5 | API — perigos e projeto de Fuel Gas Mix Drum | Open — Awaiting Response or Evaluation/Approval of Response |
| 6 | API — prevenção de overflow de vasos | Open — Acceptable Response or Alternate Response |
| 7 | ISA — desempenho de alarm floods de curta duração | Open — Acceptable Response or Alternate Response |
O que profissionais de SST podem aprender
Indicadores de acidentes pessoais e indicadores de segurança de processo respondem a perguntas diferentes. Uma instalação pode ter poucos acidentes cotidianos e, ainda assim, manter caminhos de perda de contenção capazes de produzir consequências graves.
A atuação integrada de SST, operação, automação, manutenção e engenharia ajuda a identificar condições que uma disciplina isolada não enxerga. Handover, excesso de alarmes, bypasses e ações pendentes também são sinais sobre a saúde das barreiras.
- Avalie a capacidade de resposta em condições degradadas, não apenas em operação estável.
- Inclua decisões de parada e escalonamento nas análises e exercícios.
- Examine fatores humanos como condições do sistema de trabalho.
- Pergunte por que a organização chegou a depender daquela decisão urgente.
- Acompanhe implementação e eficácia das recomendações de investigação.
E no Brasil? Como transferir o aprendizado
As conclusões do CSB não tornam a regulamentação dos EUA aplicável ao Brasil. O aprendizado pode orientar instalações brasileiras com inflamáveis e processos perigosos, integrando análise de riscos, procedimentos, capacitação, gestão de mudanças e resposta a emergências.
A NR-20, quando aplicável à instalação e à atividade, oferece o enquadramento brasileiro de segurança e saúde no trabalho com inflamáveis e combustíveis. A gestão de riscos ocupacionais e o PGR devem conversar com as análises especializadas de processo; um inventário genérico não substitui o estudo de caminhos de overflow, falhas de controle ou perda de contenção.
ISA-18.2, IEC 62682 e EEMUA 191 são referências técnicas internacionais. Sua utilização exige avaliar o contexto e consultar a edição pertinente. Melhorar a filosofia de alarmes deve ser acompanhado de avaliação das salvaguardas e das rotinas operacionais, sem se limitar a reduzir notificações.
Checklist rápido de gerenciamento de alarmes
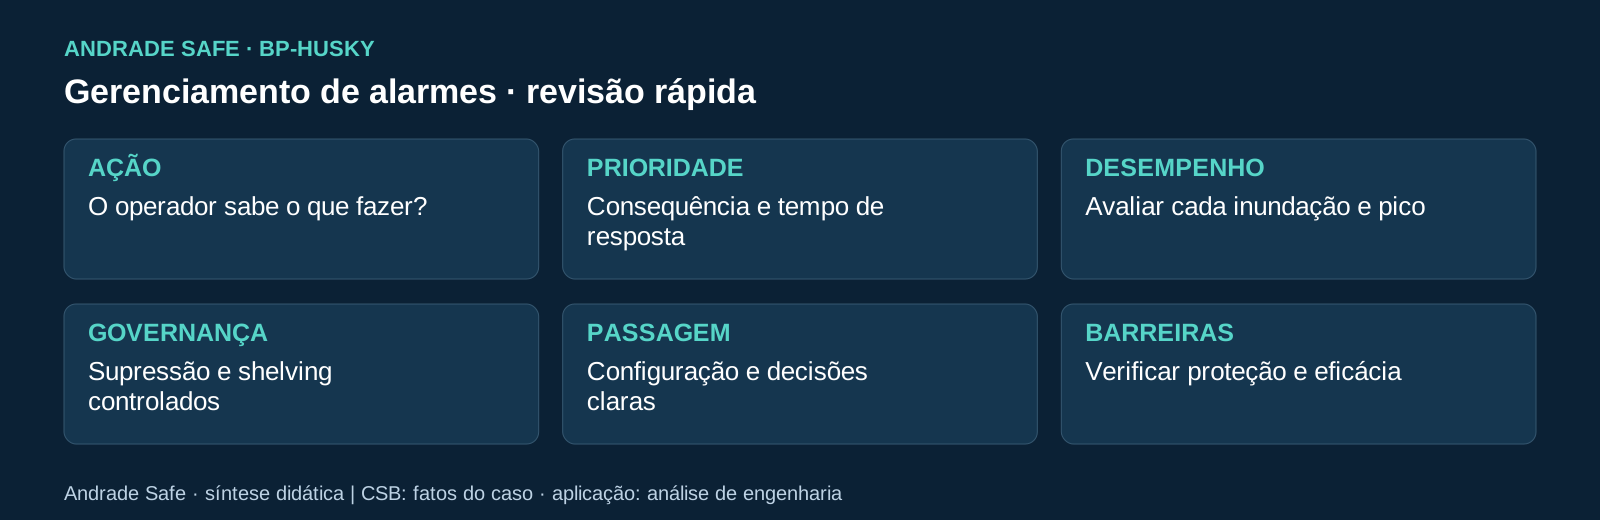
Use as perguntas como ponto de partida para uma revisão conjunta de operação e engenharia. Respostas sem evidência devem virar itens de investigação, com responsável e prazo.
- Cada alarme exige uma ação clara do operador?
- A prioridade considera consequência e tempo disponível para resposta?
- Alarmes duplicados, stale e nuisance são identificados e tratados?
- O desempenho é avaliado durante upsets, além das médias mensais?
- Cada alarm flood é analisado quanto a duração, volume e pico?
- Shelving e supressão têm autorização, motivo, prazo e trilha de auditoria?
- A equipe conhece o estado seguro e a sequência para alcançá-lo?
- A passagem de turno inclui bypasses, alarmes suprimidos e ameaças emergentes?
- Há critérios claros para escalonamento, shutdown ou circulação?
- Stop work authority é treinada e apoiada pela liderança?
- Quase-acidentes geram ações implementadas e verificação de eficácia?
- As proteções necessárias reduzem a dependência de uma única resposta humana?
Um sistema que ajuda a reconhecer o que importa
O número 3.712 chama atenção, mas a resposta não é apenas ter menos alarmes. É garantir sinais relevantes e acionáveis, barreiras adequadas aos riscos críticos, decisões previstas para situações anormais e aprendizagem que modifica o sistema.
Alarmes são uma linguagem entre o processo e quem o opera. Quando essa linguagem vira ruído, a organização precisa redesenhar o sistema e as condições de resposta. Pedir mais atenção ao operador não recupera o tempo, a informação e as proteções que deveriam estar disponíveis.
Perguntas frequentes
O que é alarm flooding?
Alarm flooding, ou inundação de alarmes, é uma condição em que a quantidade e a taxa de chegada de alarmes ultrapassam a capacidade prática de discriminação e resposta da equipe. Reconhecer ou silenciar uma indicação na tela não equivale a diagnosticar sua causa ou recuperar o processo.
Um alarme é uma barreira automática?
Um evento pode ser apenas um registro de mudança de estado. Um alarme sinaliza uma condição que requer resposta do operador. Um trip ou intertravamento executa uma ação automática segundo sua lógica. Um Safety Instrumented System (SIS) implementa funções instrumentadas de segurança (SIFs), cuja especificação e independência devem decorrer da análise de risco.
Existe uma taxa universal aceitável de alarmes?
Não existe neste artigo uma taxa universal de alarmes aceitáveis. A adequação depende do processo, da posição de operação, do contexto e das referências técnicas aplicáveis. O objetivo é recuperar significado, não alcançar um número bonito no painel.
Referências desta atualização
Informação conferida em 8 fontes em 07/10/2026.
- BP-Husky — final investigation reportCSB · publicado em 24/06/2024
- BP-Husky — official safety videoCSB · publicado em 01/10/2026
- BP-Husky — safety video releaseCSB · publicado em 30/09/2026
- BP-Husky — seven recommendations and current statusCSB
- ISA-18 Series of Standards — public catalogueISA
- IEC 62682:2022 — edition 2.0IEC · publicado em 08/12/2022
- EEMUA Publications Catalogue — Publication 191, fourth editionEEMUA
- NR-20 — Segurança e saúde no trabalho com inflamáveis e combustíveisMinistério do Trabalho e Emprego