
Crise na rede da FAA em novembro de 2026: o que 17 centros afetados ensinam sobre redundância, falhas comuns e segurança de sistemas críticos.
A função crítica vem antes dos equipamentos
Em uma frase: uma infraestrutura crítica não precisa perder todos os equipamentos para perder a confiança necessária à operação. Confiabilidade significa preservar funções essenciais, inclusive quando os componentes se comportam de forma imprevista.
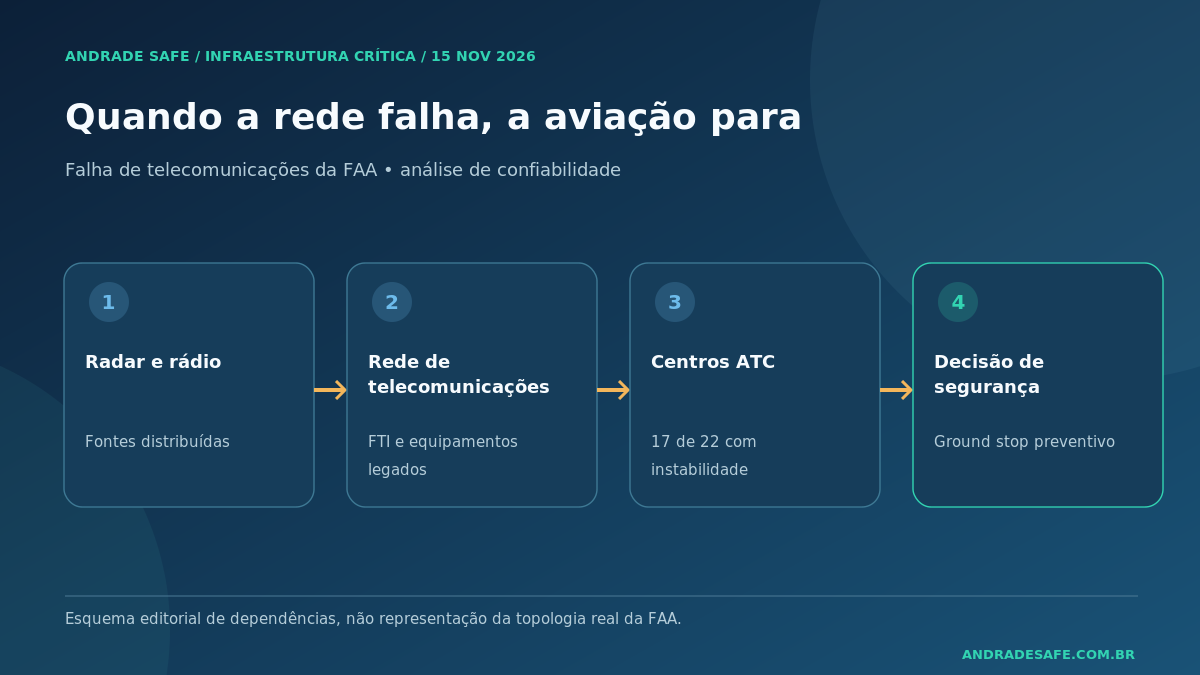
O dia em que a infraestrutura digital interrompeu decolagens
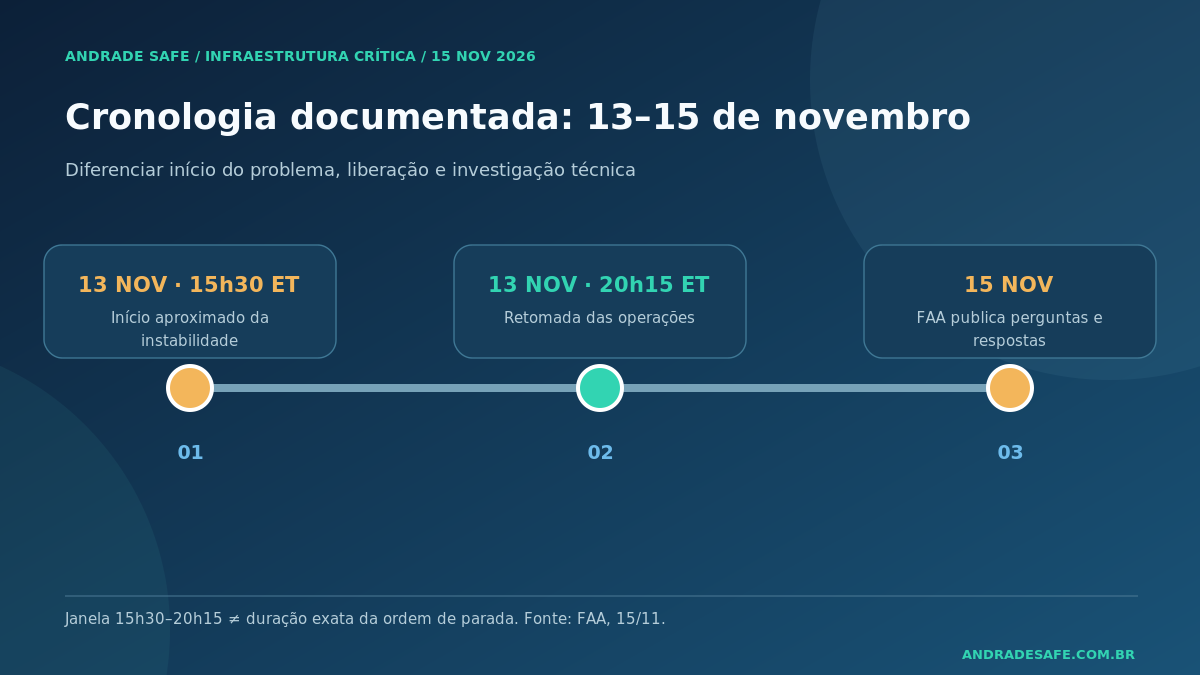
Em 13 de novembro de 2026, a Federal Aviation Administration (FAA), autoridade federal de aviação dos Estados Unidos, determinou a suspensão preventiva de decolagens em âmbito nacional (nationwide ground stop) diante de instabilidade nos sistemas de telecomunicações que apoiam os controladores de tráfego aéreo. Segundo o comunicado oficial de 15/11, a instabilidade teve início por volta de 15h30, horário do leste dos EUA, e as operações começaram a ser retomadas às 20h15. Trata-se de uma janela de aproximadamente quatro horas e 45 minutos entre o início informado do problema e a retomada, não necessariamente da duração exata da ordem de parada [1].
A FAA informou que a instabilidade atingiu 17 dos 22 centros regionais de controle em rota (Air Route Traffic Control Centers, ARTCCs), além de alcançar instalações de aproximação terminal. O sistema não apresentou apagão absoluto: algumas frequências de rádio e informações de radar permaneceram confiáveis, permitindo a continuidade segura dos voos já em andamento. A interrupção de decolagens foi uma barreira preventiva, não prova de que aeronaves em voo estivessem sem orientação [1][2].
O Departamento de Transportes divulgou que mais de 3.500 voos foram gerenciados durante a operação de contenção e que milhares de operações retomaram após a suspensão [2]. A FAA publicou um número aproximado de 12.462 cancelamentos em 13/11, advertindo explicitamente que nem todos foram causados diretamente pelo ground stop [1]. Não é correto transformar esse número em prejuízo financeiro, custo unitário ou consequência exclusivamente atribuível à falha sem uma metodologia verificável.
O que a FAA confirmou — e o que ainda é investigado
A comunicação oficial descreve uma rede de telecomunicações existente, a FTI, com equipamentos legados que se tornaram instáveis durante um fluxo anormal de dados. A FAA relatou cerca de 1.000 tentativas de conexão a cada quatro a cinco segundos. Isso equivale aritmeticamente a 200 a 250 tentativas por segundo no indicador citado; não significa que toda a rede processou somente essa vazão nem permite inferir a largura de banda total [1].
A investigação inicial apontava dois locais potencialmente ligados à origem desse tráfego: uma instalação de radar em Amarillo, Texas, e uma estação de rádio em El Dorado, Arkansas. A contratada L3Harris havia trabalhado em um roteador na instalação de El Dorado. Isolar os locais suspeitos e desativar uma função de difusão nos roteadores ajudou a estabilizar a rede; a mesma função foi desabilitada preventivamente em aproximadamente 60 equipamentos semelhantes [1].
É fundamental não converter essa sequência em um laudo causal. Ainda era necessário demonstrar, por evidência técnica, qual evento iniciou o tráfego, como ele se propagou, que dependências foram afetadas e por que as barreiras não o limitaram antes de alcançar tantos centros. A FAA declarou não ter encontrado indícios de ataque cibernético, mas disse que continuava investigando a causa raiz [1].
Fatos documentados: paralisação preventiva; 17 de 22 centros com instabilidade; dados de radar/comunicação degradados em parte da infraestrutura; isolamento de dois locais e alteração preventiva em roteadores. Questões em aberto: mecanismo iniciador exato; lógica de propagação; desempenho das redundâncias; responsabilidade técnica específica; resultados finais da investigação.
Atualização oficial de 15/11/2026: o Departamento de Transportes informou que os roteadores relacionados ao episódio estavam em diagnóstico nos laboratórios da L3Harris, com participação de pessoal da FAA. A análise do equipamento e do processo de instalação seguia em andamento; esse comunicado não é um laudo final de causa raiz [6].
O que realmente significa uma falha de infraestrutura crítica?
Em sistemas comuns, um erro pode se manifestar como lentidão. Na aviação, uma informação atrasada, inconsistente ou não confiável pode ser operacionalmente tão relevante quanto a indisponibilidade. A decisão sobre continuar ou interromper atividades exige três perguntas: os dados chegam? são corretos e oportunos? é seguro agir com eles?
Um sistema pode estar ligado, aceitar pacotes e responder a testes simples, mas não cumprir sua função essencial. Por isso, diferencie: disponibilidade (serviço acessível), integridade (informação preservada e coerente), latência/atualidade (informação chega a tempo) e segurança (estado no qual o risco permanece controlado). Não são sinônimos.
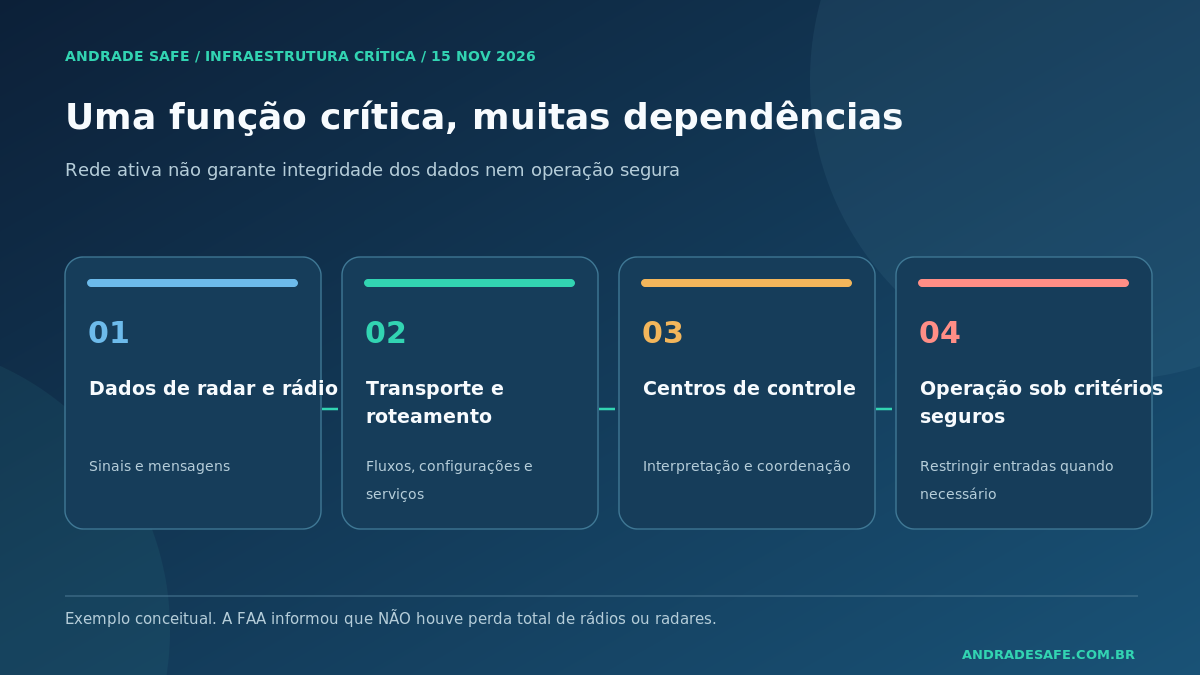
A FAA não afirmou que todos os rádios e radares foram desligados. A instabilidade em múltiplos centros comprometeu a confiança no conjunto, e a autoridade adotou um procedimento conservador. Na engenharia de sistemas críticos, uma parada segura planejada pode ser evidência de uma barreira funcionando, ainda que a ocorrência revele deficiências de resiliência.
Como uma rede com equipamentos redundantes pode sofrer uma falha abrangente
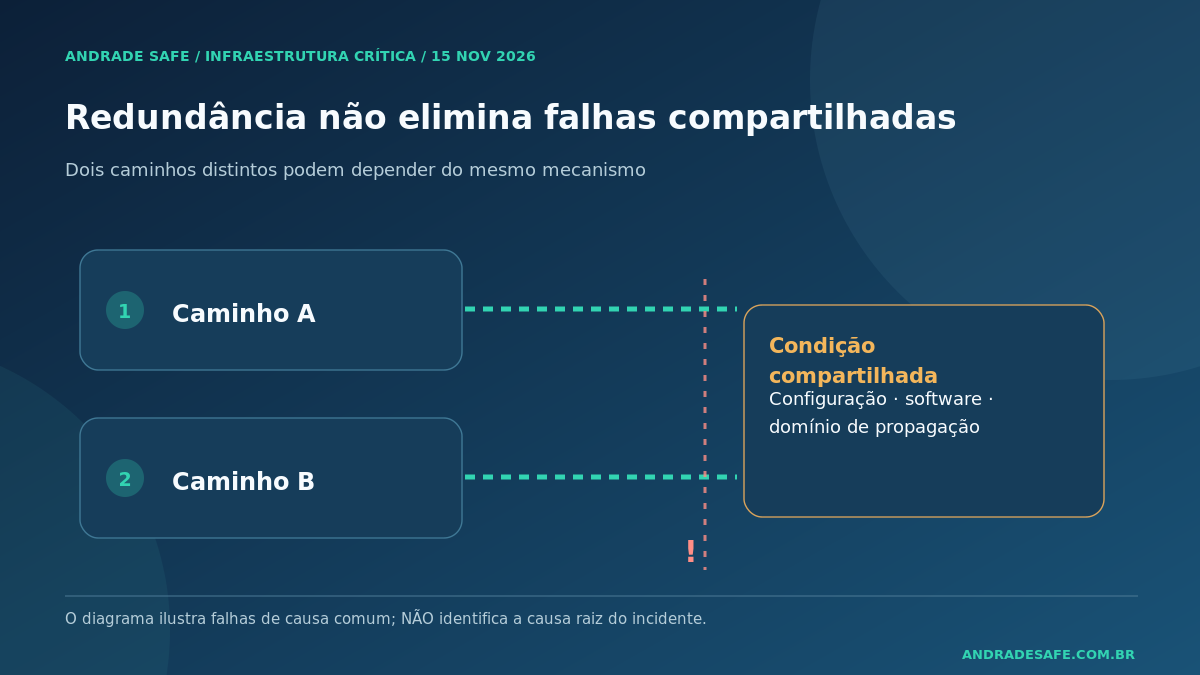
Uma arquitetura distribuída depende de mais do que roteadores. Envolve energia elétrica, circuitos, relógios, protocolos de encaminhamento, configuração, manutenção, software, telemetria, equipes e decisões operacionais. Dois caminhos físicos podem continuar vulneráveis se compartilham a mesma configuração problemática, fornecedor, plano de controle, domínio de propagação ou procedimento de mudança.
Esse é o conceito de falha de causa comum: um único fator, ou uma mesma classe de condições, afeta elementos que se supunham independentes. A redundância independente reduz a probabilidade de indisponibilidade; a redundância submetida ao mesmo risco compartilhado pode ter ganho muito menor.
A orientação NIST SP 800-53, controle CP-8, discute telecomunicações alternativas e redução de pontos únicos de falha, incluindo a necessidade de evitar infraestrutura compartilhada suscetível às mesmas ameaças [3]. O NIST SP 800-34 orienta planejamento de continuidade, análise de impacto, estratégias de recuperação e exercícios [4]. Essas são referências técnicas internacionais, não exigências legais brasileiras automaticamente aplicáveis à FAA ou a empresas privadas no Brasil.
Laboratório matemático: disponibilidade não é uma promessa
Considere um equipamento com disponibilidade hipotética A = 0,98, equivalente a 98% do tempo no horizonte modelado. Sua indisponibilidade é q = 1 - A = 0,02. Para dois elementos independentes em paralelo, ambos capazes de cumprir a função e com comutação perfeita, a probabilidade de ambos falharem ao mesmo tempo é q², e a disponibilidade teórica do conjunto é:
Aₚ=1-(1-A)²
Assim, A_paralelo = 1 - 0,02² = 0,9996, ou 99,96%.
Se houver também um evento compartilhado com probabilidade hipotética c = 1% de o estado comum de indisponibilidade estar ativo em um instante amostrado, independente das falhas locais, um modelo didático é:
A꜀=(1-c) [1-(1-A)²]
Daí A_comum = 0,99 × 0,9996 = 0,989604, ou 98,9604%. O ganho frente a uma alternativa não redundante depende de como o evento comum foi definido e de quais limites de sistema estamos comparando. Não se deve comparar arquiteturas com fronteiras de risco diferentes.
Por fim, se três subsistemas críticos independentes precisarem funcionar em sequência e cada um tiver A = 0,98, a disponibilidade hipotética da cadeia é A_série = 0,98³ = 0,941192 ou 94,1192%. A redução ilustra a fragilidade de séries longas sem tolerância a falhas.
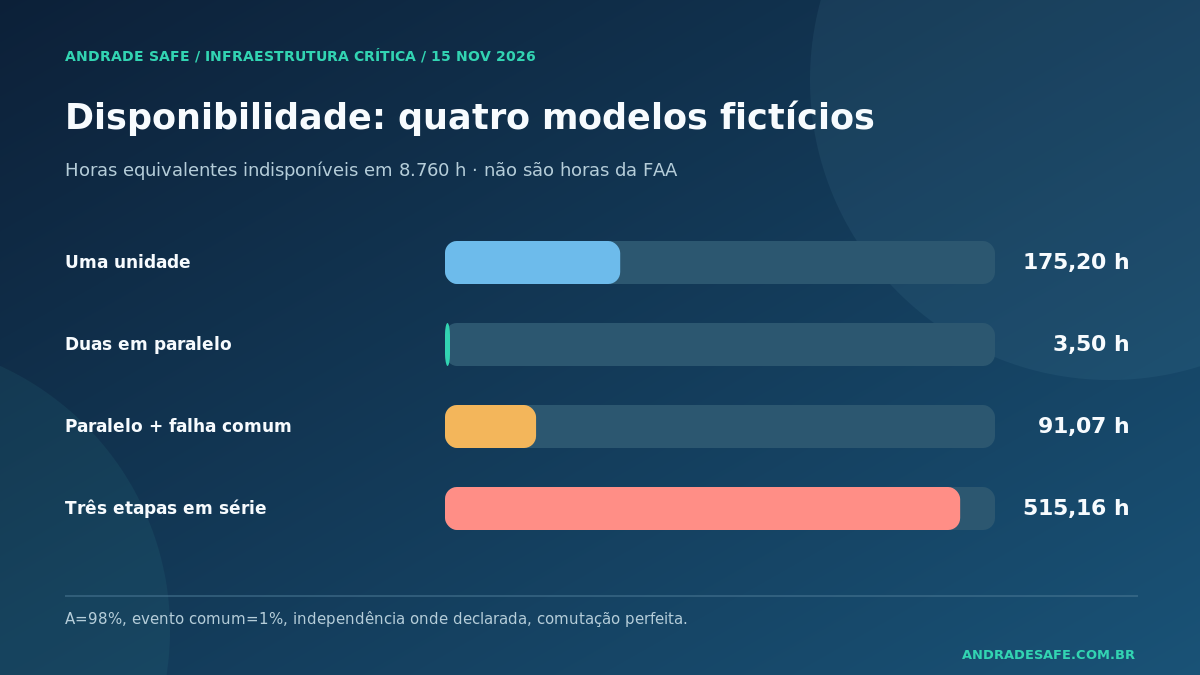
| Arquitetura matemática hipotética | Disponibilidade | Indisponibilidade equivalente em 8.760 h |
|---|---|---|
| Uma unidade, A = 98% | 98,0000% | 175,20 h |
| Duas unidades independentes, paralelo | 99,9600% | 3,50 h |
| Paralelo com evento comum de 1% | 98,9604% | 91,07 h |
| Três etapas independentes em série | 94,1192% | 515,16 h |
Explore o laboratório de confiabilidade
Essas horas são valores matemáticos esperados sob hipóteses estacionárias, não horas efetivamente perdidas pela FAA. O modelo omite tempos de reparo, dependências, manutenção, falha de comutação, degradação, cobertura de diagnóstico e muitos mecanismos reais. Em sistemas de segurança, disponibilidade sozinha tampouco substitui análise de integridade e perigos.
Explore o laboratório interativo: ajuste a disponibilidade de cada componente, a probabilidade de falha comum e o número de etapas em série; observe o resultado e a ressalva técnica correspondente.
Laboratório: confiabilidade de redes críticas
Compare modelos matemáticos de disponibilidade em série, redundância independente e falhas de causa comum. Não representa a rede real da FAA.
Parâmetros hipotéticos
Dica: aumentar a redundância ajuda pouco se ambos os caminhos dependem do mesmo serviço ou da mesma configuração.
Modelo ilustrativo. Assume independência entre componentes, exceto pelo evento comum declarado, e comutação perfeita; não prevê falhas nem segurança da FAA ou de qualquer instalação.
Resultados calculados
- Uma unidade
- 98,0000%Disponibilidade do componente
- Paralelo independente
- 99,9600%Dois componentes idênticos
- Paralelo com falha comum
- 98,9604%Cenário com evento compartilhado
- Etapas em série
- 94,1192%Todas as etapas obrigatórias
Aₚ = 1 − (1 − A)²
A꜀ = (1 − c) × Aₚ
Aₛ = Aⁿ
H = (1 − Aₘ) × 8.760 h
Comparação de indisponibilidade equivalente
| Modelo | Horas/ano |
|---|---|
| Uma unidade | 175,20 h |
| Paralelo independente | 3,50 h |
| Paralelo + falha comum | 91,07 h |
| Etapas em série | 515,16 h |
Como interpretar
Os valores são médias matemáticas para um horizonte convencional de 8.760 horas, não medidas de campo. A vida real depende de diagnóstico, cobertura de falhas, transição, manutenção, dependências e reparação.
Compare sistemas com as mesmas fronteiras. Se o risco compartilhado também afeta a alternativa de unidade única, inclua-o nesse modelo antes de concluir qual arquitetura é melhor.
Uma unidade exposta ao mesmo evento comum: (1 − c) × A = 97,0200%. Paralelo sob esse mesmo risco: 98,9604%.
Referências metodológicas: NIST SP 800-34 e NIST SP 800-53 (CP-8); fato jornalístico: comunicado FAA de 15/11/2026. O laboratório NÃO reproduz a falha investigada.
A engenharia da mudança: como uma intervenção local amplia o risco
Em infraestruturas complexas, mudanças aparentemente rotineiras precisam de gestão proporcional ao seu raio de impacto. Antes de trocar um roteador, por exemplo, uma análise robusta deve documentar configuração, dependências, compatibilidade, janela de intervenção, plano de retorno, critérios de aceitação e telemetria. Depois, deve confirmar que o comportamento da rede continua dentro dos limites seguros.
Essa lista é uma recomendação geral de engenharia de sistemas, não descrição de documentos encontrados na investigação da FAA. O órgão já informou que reavaliaria janelas de manutenção em instalações remotas após o episódio [1]. O fato de um procedimento ter funcionado por anos não comprova que permaneça seguro sob uma rede que evoluiu de escala, topologia e tráfego.
Três barreiras práticas merecem destaque. Segmentação/limitação de propagação restringe a extensão de um comportamento anormal. Observabilidade identifica volumes, formatos e destinos de tráfego incompatíveis com o padrão. Rollback verificado permite retornar a um estado estável sem introduzir falhas adicionais. Nenhuma dessas barreiras isoladamente garante resiliência; sua eficiência depende de testes realistas e responsabilidade operacional definida.
Como funciona uma decisão de parada segura
A gestão de tráfego aéreo requer margens de separação, informações coerentes e comunicação estável. Quando a qualidade dos dados não pode ser assegurada, a resposta prudente pode envolver reduzir a demanda do sistema, parar novas entradas e preservar o processamento seguro do que já está em curso. É análogo — apenas no princípio, não na tecnologia — a uma parada controlada de processos industriais, redes elétricas, instalações hospitalares e plataformas de pagamento.
O retorno também tem engenharia: identificar o comportamento anormal; isolar a propagação; restaurar estabilidade mensurável; observar sob carga; liberar progressivamente as operações; acompanhar os efeitos logísticos acumulados. Levantar a ordem de parada não elimina instantaneamente atrasos de tripulações, reposicionamento de aeronaves e restrições de malha.
Na recuperação, RTO é o tempo-alvo para restabelecer um recurso antes de impactos inaceitáveis; RPO indica até que ponto anterior à interrupção os dados precisam ser recuperáveis, refletindo a perda tolerável de dados. Em controle em tempo real, recuperar um backup não basta: atualidade, coerência e validação dos dados também condicionam a retomada. Não conhecemos os objetivos definidos para a FTI neste incidente [4].
O que empresas brasileiras podem aprender
A lição não se limita a aeroportos. Indústrias, hospitais, redes de distribuição de energia, saneamento e sistemas de logística dependem de infraestrutura digital que muitas vezes se tornou parte de sua segurança funcional e continuidade operacional.
Uma avaliação prática começa com um inventário de serviços críticos, a identificação de dependências ocultas e a análise dos cenários de falha comum. Em seguida, é preciso testar os caminhos alternativos, os limites de taxa, a resposta de alarme, a gestão de mudanças, os critérios de parada e os procedimentos de recuperação. Para projetos que envolvam segurança de máquinas, processos ou energia, também se deve verificar os requisitos normativos efetivamente aplicáveis ao caso e à instalação, sem generalizações.
A pergunta gerencial mais importante não é apenas "temos backup?", mas "nossos caminhos alternativos continuam independentes quando a falha se propaga?".
Conclusão: uma rede estável precisa ser também uma rede confiável
A ocorrência de novembro de 2026 mostrou como a aviação moderna depende de uma arquitetura invisível de telecomunicações. Não é suficiente que o equipamento esteja energizado ou que existam rotas alternativas no diagrama. É necessário provar que as funções críticas permanecem coerentes durante mudanças, falhas e recuperação.
A resposta preventiva da FAA preservou a segurança operacional, mas o episódio abre perguntas legítimas sobre o comportamento de redes legadas e as fronteiras da redundância. A investigação poderá responder ao mecanismo específico; o aprendizado técnico é transferível desde já.
Apuração e atualização
Nota editorial: fatos apurados em 15/11/2026. Se houver novas conclusões ou mudanças no número de voos, atualizar os três idiomas, identificar a nova data de revisão e preservar a URL de artigo vivo.
Leituras conectadas
Oleoduto Leste-Oeste: redundância e resiliência →
Hamaoka: integridade de dados e decisões →
Arquivos do estudo
Modelo ilustrativo. Assume independência entre componentes, exceto pelo evento comum declarado, e comutação perfeita; não prevê falhas nem segurança da FAA ou de qualquer instalação.
Fontes e referências
[1] FAA. Nationwide Ground Stop: Questions and Answers. 15 nov. 2026 →
[4] NIST. SP 800-34 Rev. 1 — Contingency Planning Guide →
[5] Reuters. U.S. flight disruptions continue into third day. 15 nov. 2026 →
Perguntas frequentes
A FAA perdeu todas as comunicações e radares?
Não. A agência informou que algumas frequências e sinais continuaram confiáveis.
A paralisação foi um ciberataque?
Até 15/11, a FAA dizia não ter indícios disso e continuava investigando a causa raiz.
Dois roteadores garantem alta disponibilidade?
Não. Depende de independência real, comutação, configuração, testes, alimentação, software e riscos compartilhados.
Disponibilidade de 99,96% equivale a 99,96% de segurança?
Não. Disponibilidade mede uma dimensão do serviço; segurança depende da probabilidade e das consequências de falhas perigosas, além de barreiras específicas.
Por que uma falha local pode afetar muitos centros?
Redes interligadas podem compartilhar planos de controle, regras, caminhos e serviços. O mecanismo exato dessa ocorrência permanece objeto de investigação.
O que deve ser auditado antes da próxima intervenção?
Dependências, plano de mudança, testes, condições de rollback, monitoramento e critérios de operação degradada.
Referências desta atualização
Informação conferida em 6 fontes em 15/11/2026.
- FAA. Nationwide Ground Stop: Questions and Answers. 15 nov. 2026FAA. Nationwide Ground Stop: Questions and Answers. 15 nov. 2026
- U.S. Department of Transportation. Restoration of Airspace Following Nationwide Ground Stop. 14 nov. 2026U.S. Department of Transportation. Restoration of Airspace Following Nationwide Ground Stop. 14 nov. 2026
- NIST. SP 800-53 Rev. 5 — Security and Privacy Controls for Information Systems and OrganizationsNIST. SP 800-53 Rev. 5 — Security and Privacy Controls for Information Systems and Organizations
- NIST. SP 800-34 Rev. 1 — Contingency Planning GuideNIST. SP 800-34 Rev. 1 — Contingency Planning Guide
- Reuters. U.S. flight disruptions continue into third day. 15 nov. 2026Reuters. U.S. flight disruptions continue into third day. 15 nov. 2026
- U.S. DOT — atualização da investigação, 15/11/2026U.S. DOT — atualização da investigação