
El fallo de la red de la FAA en noviembre de 2026: 17 centros afectados, redundancia, causas comunes y seguridad de infraestructuras críticas.
La función crítica precede a los equipos
Tesis: una infraestructura crítica no necesita perder todos sus equipos para dejar de ser apta para la operación normal. La fiabilidad exige mantener funciones esenciales, información confiable y decisiones seguras aun cuando aparecen comportamientos inesperados.
Una interrupción digital con consecuencias físicas
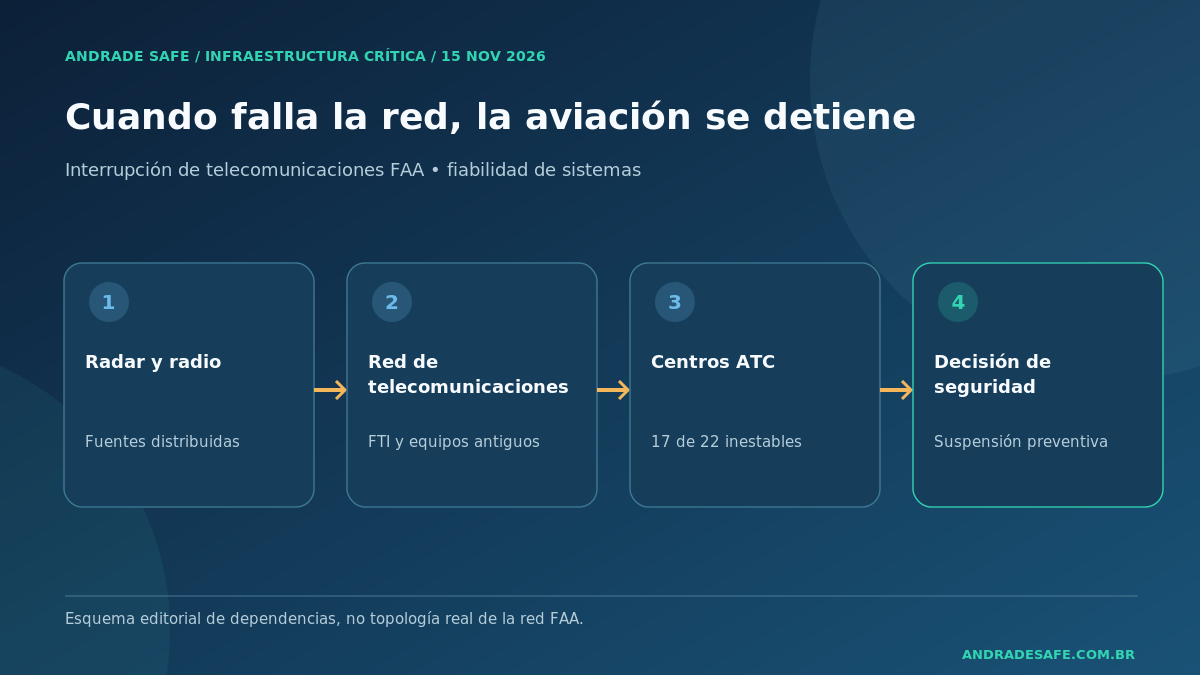
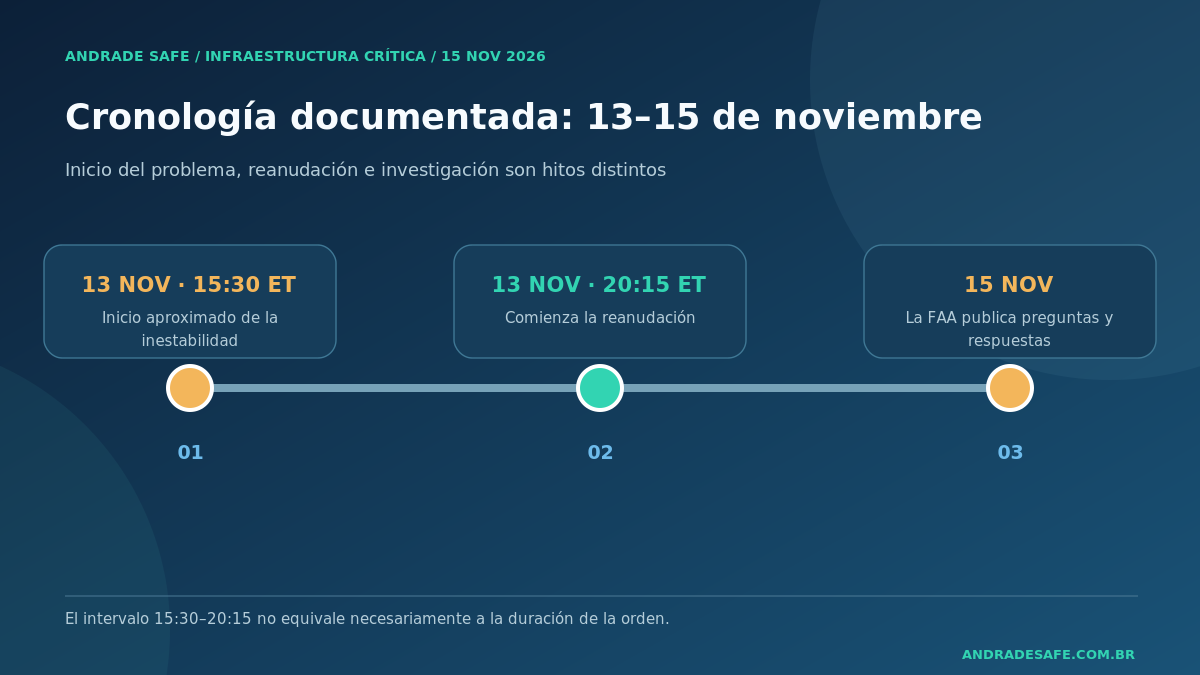
El 13 de noviembre de 2026, la Federal Aviation Administration (FAA) de Estados Unidos ordenó la suspensión preventiva de los despegues en todo el país (nationwide ground stop) debido a inestabilidad en las telecomunicaciones que respaldan el control del tráfico aéreo. En su explicación del 15 de noviembre, el organismo señaló que el problema técnico comenzó aproximadamente a las 15:30, hora del este, y que la reanudación operativa se inició a las 20:15. Entre ambas referencias transcurrieron unas cuatro horas y 45 minutos, sin que ese intervalo represente necesariamente la duración exacta de la orden [1].
La FAA reportó inestabilidad en 17 de los 22 centros regionales de control en ruta, con propagación a varias instalaciones de control de aproximación. No ocurrió una pérdida total de todas las radios y señales de radar: algunos canales continuaron funcionando de forma confiable, permitiendo gestionar los vuelos que ya estaban en el aire. La suspensión de salidas constituyó una medida de precaución para conservar la seguridad [1][2].
El Departamento de Transporte informó sobre la gestión segura de más de 3.500 vuelos y una recuperación gradual [2]. La FAA comunicó aproximadamente 12.462 cancelaciones el 13 de noviembre, indicando expresamente que no todas se debían directamente a la suspensión nacional [1]. Es incorrecto atribuir toda la cifra al incidente o calcular pérdidas económicas sin un método sólido.
Hechos comprobados y puntos todavía abiertos
Según la FAA, los equipos antiguos de la infraestructura de telecomunicaciones FTI perdieron estabilidad ante un flujo anómalo de datos. La agencia mencionó alrededor de 1.000 intentos de conexión cada cuatro o cinco segundos, equivalentes a unos 200–250 intentos por segundo en esa métrica específica. No se trata de la capacidad total de la red ni del volumen de todos sus paquetes [1].
La investigación preliminar examinó dos ubicaciones potencialmente relacionadas: un centro de radar en Amarillo, Texas, y una estación de radio en El Dorado, Arkansas. El proveedor L3Harris había trabajado en la estación de El Dorado, incluida la instalación de un router. Al bloquear esas dos ubicaciones, el sistema recuperó estabilidad; como precaución también se deshabilitó una función de difusión en unos 60 routers similares [1].
Estos indicios no equivalen a una conclusión forense definitiva. Todavía deben determinarse el evento iniciador, el mecanismo de propagación, la respuesta de las redundancias y los factores organizativos o técnicos implicados. La FAA declaró que no había indicios de ataque informático en la evidencia disponible hasta el 15 de noviembre, aunque seguía investigando la causa raíz [1].
Documentado: suspensión preventiva; 17 de 22 centros afectados por inestabilidad; problemas parciales de datos y comunicaciones; medidas de aislamiento y deshabilitación preventiva. Pendiente: causa inicial exacta, dependencias técnicas, alcance de eventuales fallos comunes y conclusiones finales.
Actualización oficial del 15/11/2026: el Departamento de Transporte informó que los routers relacionados con el episodio estaban en diagnóstico en los laboratorios de L3Harris, con participación de personal de la FAA. Continuaba el examen del equipo y del proceso de instalación; no se trata de un informe definitivo de causa raíz [6].
La disponibilidad no equivale a integridad ni a seguridad
Un dispositivo de red puede permanecer encendido y contestar pruebas de conexión mientras envía información retrasada o incoherente. La disponibilidad mide la accesibilidad del servicio; la integridad examina la coherencia y fidelidad de los datos; la oportunidad temporal exige que la información llegue a tiempo; la seguridad requiere que los riesgos de la operación sigan controlados.
Son dimensiones relacionadas, pero diferentes. Un controlador que recibe datos poco confiables puede necesitar restringir operaciones aunque una parte significativa de la red continúe activa. Por eso, detener de forma segura los despegues puede demostrar que una barrera de protección funcionó, sin eliminar la obligación de investigar el fallo.
La distinción es útil para plantas industriales, hospitales, redes eléctricas, instalaciones de agua y transporte: tener electricidad y conectividad no significa que un sistema cumpla efectivamente su función crítica.
Redundancia y fallo de causa común
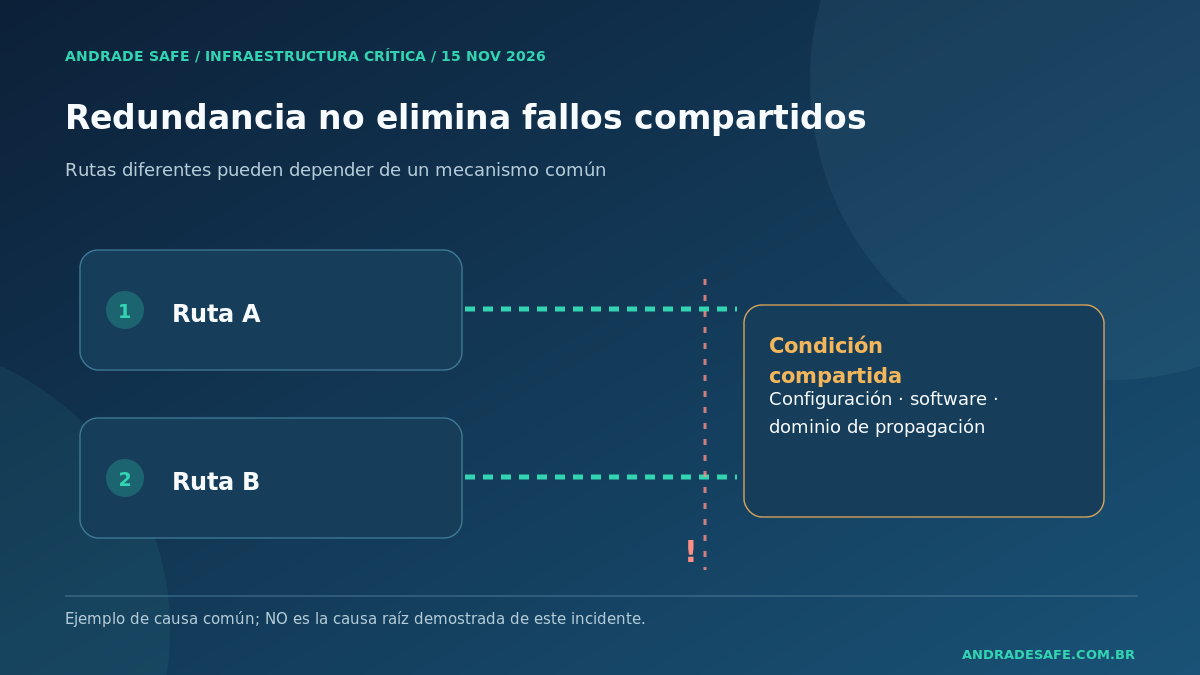
Una red distribuida depende de equipos, energía, software, relojes, configuración, protocolos, proveedores, mantenimiento y decisiones humanas. Dos equipos supuestamente redundantes pueden compartir una actualización defectuosa, un protocolo vulnerable, una fuente de energía, una plantilla de configuración o una ruta de comunicación.
El fallo de causa común describe condiciones que pueden afectar simultáneamente a elementos considerados independientes. La redundancia verdadera necesita separación de riesgos, pruebas y mecanismos de aislamiento; simplemente duplicar equipos no garantiza tolerancia a fallos.
Como referencia técnica, NIST SP 800-53 (CP-8) trata servicios alternativos de telecomunicaciones y reducción de puntos únicos de fallo; NIST SP 800-34 aborda planes de contingencia, análisis de impacto y recuperación [3][4]. No son automáticamente obligaciones legales para cualquier entidad brasileña o extranjera.
Laboratorio: sistemas en serie, paralelo y con causa común
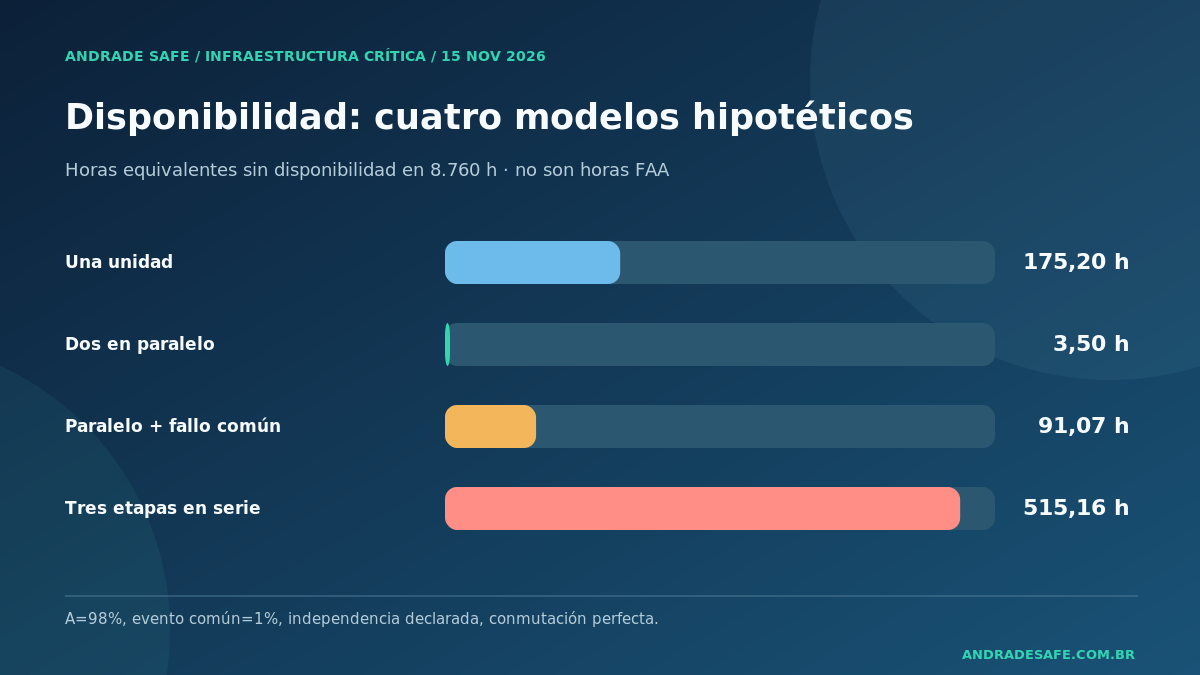
Considérese un componente hipotético con disponibilidad A = 0,98 durante un período definido. Su indisponibilidad es q = 1 − A = 0,02.
Dos equipos independientes en paralelo, cada uno capaz de prestar todo el servicio y con conmutación perfecta, presentan:
Aₚ=1-(1-A)²=1-0,02²=0,9996
El resultado es 99,96 %. Ahora supóngase un estado compartido de indisponibilidad activo con probabilidad c = 0,01 en un instante muestreado, independiente de los fallos de las ramas:
A꜀=(1-c)[1-(1-A)²]=0,99 × 0,9996=0,989604
El conjunto pasa a 98,9604 %. La comparación con una sola unidad debe respetar el mismo límite del sistema y considerar si el evento común también afecta a la alternativa de referencia.
Con tres elementos independientes en serie, todos obligatorios, la disponibilidad sería:
Aₛ=A³=0,98³=0,941192
| Modelo hipotético | Disponibilidad | Horas equivalentes no disponibles al año |
|---|---|---|
| Una unidad | 98,0000 % | 175,20 h |
| Dos unidades independientes en paralelo | 99,9600 % | 3,50 h |
| Paralelo con evento común del 1 % | 98,9604 % | 91,07 h |
| Tres unidades en serie | 94,1192 % | 515,16 h |
Explore el laboratorio de fiabilidad
Son equivalencias matemáticas basadas en hipótesis, no mediciones ni predicciones de la FAA. El modelo ignora reparaciones, conmutación imperfecta, dependencias ocultas, fallos intermitentes y otros factores. Tampoco certifica la seguridad de un sistema real.
Laboratorio interactivo: modifique la disponibilidad, el riesgo compartido y la cantidad de etapas, y compruebe cómo cambian los resultados.
Laboratorio: fiabilidad de redes críticas
Compare modelos matemáticos de disponibilidad en serie, redundancia independiente y fallos de causa común. No representa la red real de la FAA.
Parámetros hipotéticos
Consejo: duplicar equipos ayuda poco si ambos caminos dependen del mismo servicio o configuración.
Modelo ilustrativo. Supone independencia entre componentes, salvo el evento común indicado, y conmutación perfecta. No predice fallos de la FAA ni certifica la seguridad.
Resultados calculados
- Una unidad
- 98,0000%Disponibilidad del componente
- Paralelo independiente
- 99,9600%Dos componentes idénticos
- Paralelo con fallo común
- 98,9604%Escenario con evento compartido
- Etapas en serie
- 94,1192%Todas las etapas obligatorias
Aₚ = 1 − (1 − A)²
A꜀ = (1 − c) × Aₚ
Aₛ = Aⁿ
H = (1 − Aₘ) × 8.760 h
Comparación de indisponibilidad equivalente
| Modelo | Horas/año |
|---|---|
| Una unidad | 175,20 h |
| Paralelo independiente | 3,50 h |
| Paralelo + fallo común | 91,07 h |
| Etapas en serie | 515,16 h |
Cómo interpretar
Los valores son promedios matemáticos en un período convencional de 8.760 horas, no mediciones reales. La operación depende de diagnóstico, conmutación, mantenimiento, dependencias y reparación.
Compare arquitecturas con los mismos límites. Si el riesgo común afecta también a una unidad individual, inclúyalo antes de decidir cuál sistema es mejor.
Una unidad expuesta al mismo evento común: (1 − c) × A = 97,0200%. Paralelo bajo el mismo riesgo: 98,9604%.
Metodología: NIST SP 800-34 y NIST SP 800-53 (CP-8); contexto FAA: comunicado del 15/11/2026. Este laboratorio NO reconstruye el fallo investigado.
Cambios locales, efectos globales
Un trabajo rutinario en un equipo remoto puede tener consecuencias mucho mayores que su ubicación física. La gestión de cambios debería considerar dependencias, validaciones, configuración, compatibilidad de versiones, ventanas de mantenimiento, pruebas, monitoreo y un mecanismo de reversión. Estas son recomendaciones generales, no pruebas de que la FAA omitiera alguna actividad concreta.
La FAA indicó que revisaría los horarios de ciertas tareas de mantenimiento tras el episodio [1]. Que una práctica haya funcionado durante años no garantiza que mantenga el mismo nivel de riesgo con nuevas arquitecturas y volúmenes de tráfico.
Entre las barreras relevantes están la segmentación de la red, la limitación de propagación, la observabilidad de tasas anómalas, el despliegue gradual, los servicios alternativos independientes y los ejercicios de recuperación.
Operación degradada y retorno seguro
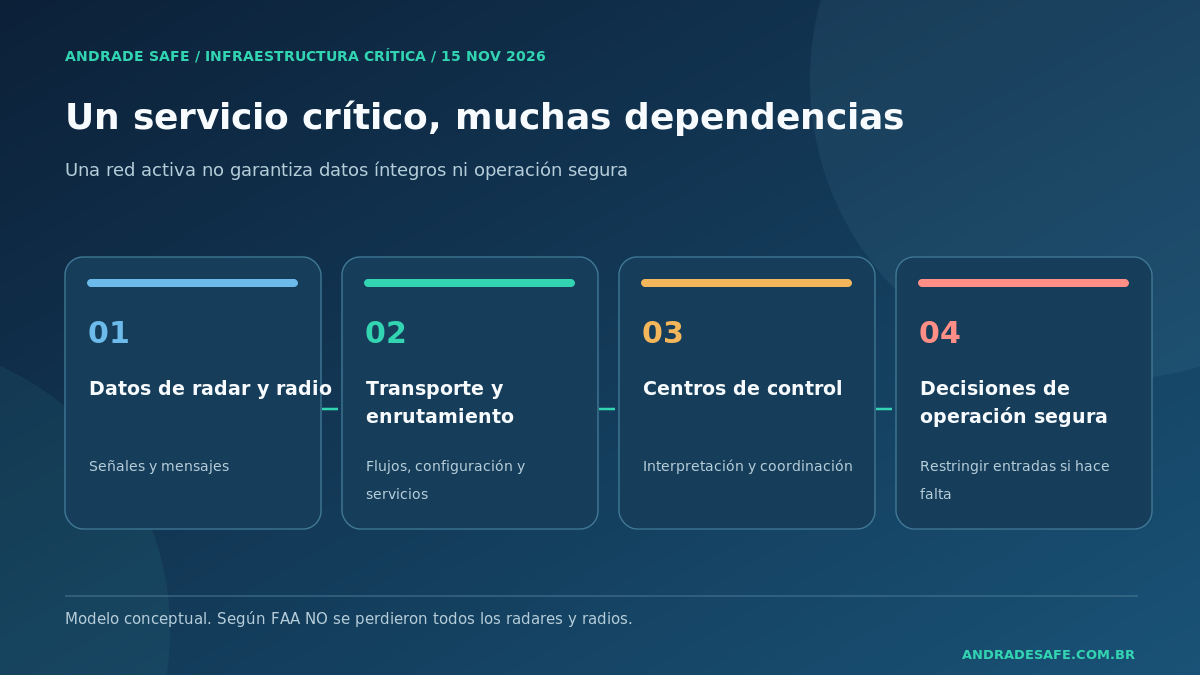
Cuando disminuye la confianza en la información, un servicio crítico puede necesitar reducir la carga de entrada para gestionar con seguridad las operaciones que ya están en proceso. En aviación, el principio se expresa mediante restricciones de salida mientras se mantiene el control de los vuelos existentes. En una fábrica podría implicar una parada controlada; los detalles técnicos y normativos son distintos.
La recuperación debe incluir aislamiento del comportamiento anómalo, restauración verificable de datos y comunicaciones, vigilancia bajo carga, reanudación progresiva y seguimiento de efectos secundarios. Levantar la orden de suspensión no normaliza de inmediato los movimientos de aeronaves y tripulaciones.
El RTO fija el tiempo objetivo para restaurar un recurso antes de impactos inaceptables; el RPO indica el punto anterior a la interrupción hasta el cual deben poder recuperarse los datos, según la pérdida tolerable. En control en tiempo real, restaurar una copia no basta: la actualidad, coherencia y validación de los datos también condicionan la reanudación. No se conocen aquí los objetivos definidos para la FTI en este incidente [4].
Lecciones para infraestructuras críticas en América Latina
La pregunta no es solo «¿tenemos respaldo?», sino «¿el respaldo sigue siendo independiente cuando el problema se propaga?». Una auditoría de resiliencia puede inventariar funciones esenciales, analizar dependencias de proveedores, separar dominios de fallo, verificar la conmutación, establecer criterios de operación degradada y probar la recuperación en condiciones representativas.
Estas prácticas son pertinentes en sistemas de salud, puertos, refinerías, energía, comunicaciones, agua y logística. Antes de presentar una norma como requisito obligatorio, deben verificarse su edición, ámbito y aplicación jurídica específica.
Conclusión
El incidente de noviembre de 2026 enseña que la red digital es parte de la infraestructura física de la aviación. La confianza en los datos es una condición de operación. La redundancia debe demostrar independencia real y la respuesta segura debe funcionar cuando la red se comporta de modo inesperado.
La investigación podrá esclarecer el origen exacto del incidente. Mientras tanto, su aprendizaje es inmediato: la fiabilidad se diseña, se comprueba y se mantiene durante las modificaciones y la recuperación, no se consigue únicamente comprando equipos adicionales.
Verificación y actualización
Artículo vivo: investigación actualizada al 15/11/2026. Modificar los tres idiomas y registrar la fecha cuando aparezca un informe definitivo.
Lecturas relacionadas
Oleoducto Este-Oeste: redundancia y resiliencia →
Hamaoka: integridad de datos y decisiones →
Archivos del estudio
Modelo ilustrativo. Supone independencia entre componentes, salvo el evento común indicado, y conmutación perfecta. No predice fallos de la FAA ni certifica la seguridad.
Fuentes y referencias
[1] FAA, Nationwide Ground Stop: Questions and Answers, 15/11/2026 →
[6] U.S. DOT — actualización de la investigación, 15/11/2026 →
Preguntas frecuentes
¿Se perdieron todas las comunicaciones y radares?
No. Según la FAA, algunas frecuencias y señales siguieron operativas.
¿Fue un ataque informático?
La agencia no había identificado indicios hasta el 15 de noviembre y continuaba investigando.
¿Dos routers aseguran alta disponibilidad?
No por sí solos; importan las dependencias, la conmutación y los riesgos compartidos.
¿99,96 % de disponibilidad significa 99,96 % de seguridad?
No. La seguridad requiere análisis de fallos peligrosos, consecuencias y barreras dedicadas.
¿Cómo puede propagarse una anomalía local?
Por servicios y reglas comunes; el recorrido específico de este incidente sigue bajo estudio.
Referencias
- FAA, Nationwide Ground Stop: Questions and Answers, 15/11/2026FAA
- Departamento de Transporte de EE. UU., Restoration of Airspace Following Nationwide Ground Stop, 14/11/2026Departamento de Transporte de EE. UU.
- NIST SP 800-53 Rev. 5NIST SP 800-53 Rev. 5
- NIST SP 800-34 Rev. 1NIST SP 800-34 Rev. 1
- Reuters, 15/11/2026Reuters
- U.S. DOT — actualización de la investigación, 15/11/2026U.S. DOT — actualización de la investigación